千问最初采用的是 MHA,也就是多头注意力。后来,为了让模型生成得更快、同时服务更多用户,它逐渐减少需要保存和读取的历史信息,并在部分模型中改变了计算这些信息的方式。
这条演进主线可以概括为:先让多个 Query 头共享 K/V,再让一部分注意力层用递推状态处理历史;与此同时,用 MoE 减少每个 token 激活的计算,用多 token 预测配合推测解码减少串行生成的开销。
本文以初代 Qwen、Qwen1.5/2/2.5/3,以及 Qwen3-Next、Qwen3.5 的公开配置为例。它们足以说明主要思路,但并不覆盖千问家族的所有型号,也不把某个分支的设计当成全家族统一的结构。
一、先理解:生成一句话,为什么需要反复读历史?
注意力机制中的三个字母,可以先这样理解:
- Q(Query):当前这个位置想寻找什么信息。
- K(Key):历史各个位置提供什么索引,用来判断与当前问题的相关性。
- V(Value):找到相关位置后,实际取回的信息。
例如生成“我把苹果放进了……”时,模型要参考前面的词,决定接下来写“篮子”还是别的内容。不同的注意力头可以关注不同关系:物体、动作、指代、语法等。这些是直观类比,实际的头并没有预先分配好的固定职责。
推理通常分为两个阶段:prefill 一次处理输入提示词,decode 则逐个生成新 token。为了避免每次都重新计算旧 token 的 K/V,模型会把它们存起来,这就是 KV cache。
缓存节省了重复计算,但每生成一个新 token,全注意力仍需要访问已有的 K/V。上下文越长,缓存越大,读历史的成本也越高。在很多 decode 场景中,瓶颈不仅是“算得多”,还包括“显存里的数据搬得慢”。
二、第一步:从 MHA 到 GQA,少存几份 K/V
MHA:每个头都有自己的 K/V
初代 Qwen-7B 的配置有 32 个注意力头;其实现把输入投影成等宽的 Q、K、V,并按同样的头数拆分。这才是判断它采用 MHA 的依据,而不只是看配置里有没有某个字段。
MHA 的特点是:每个 Query 头都有对应的 Key 头和 Value 头。表达自由度较大,但缓存也需要为这些 K/V 头分别保存历史。
MQA 与 GQA:共享程度不同的两个方案
**MQA(Multi-Query Attention)**让所有 Query 头共享一组 K/V,缓存很省,但共享程度也最高。
**GQA(Grouped-Query Attention)**采用折中方案:Query 头分组,每组共享一组 K/V。例如 32 个 Q 头搭配 8 个 KV 头,就是每 4 个 Q 头共享一组 K/V。
这里的“8 个 KV 头”意味着 8 个 K 头和 8 个 V 头,不是把两者加起来只有 8 个。共享 K/V 也不意味着 Q 头被合并:每个 Q 头仍有自己的查询和注意力结果。
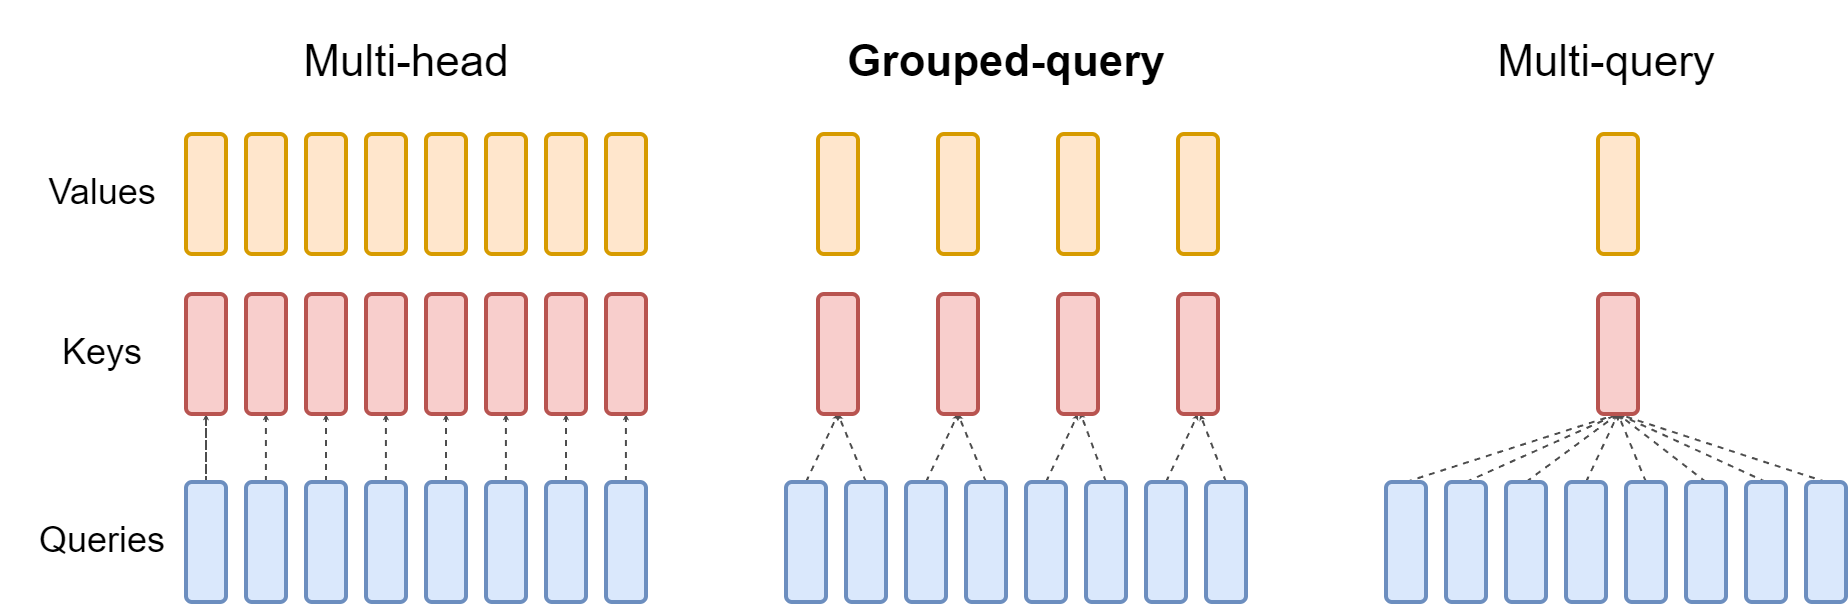
GQA 最直接的收益,是减少 K/V 投影的输出量、KV cache 容量,以及读取缓存所需的数据量。它尤其有利于长上下文生成和高并发服务。
不过,缓存缩小几倍,不等于整台模型加速几倍。Q 头仍然存在,仍然要与历史位置计算注意力;模型还有权重读取、前馈网络、通信等其他开销。
千问是哪一代开始使用 GQA 的?
准确的说法是:Qwen1.5 的部分大模型先采用,Qwen2 再推广到所有尺寸。 Qwen2 官方介绍明确指出,Qwen1.5 中此前采用 GQA 的是 32B 和 110B。
| 代表模型 | Q 头数 | KV 头数 | 注意力方式 | 相对同头维度、同层数 MHA 的缓存比例 |
|---|---|---|---|---|
| Qwen-7B | 32 | 32 | MHA | 1 |
| Qwen1.5-7B | 32 | 32 | MHA | 1 |
| Qwen1.5-32B | 40 | 8 | GQA | 1/5 |
| Qwen2-7B | 28 | 4 | GQA | 1/7 |
| Qwen2.5-7B | 28 | 4 | GQA | 1/7 |
| Qwen3-8B | 32 | 8 | GQA | 1/4 |
表格依据各模型官方配置,链接见文末。最后一列比较的是“该模型若改用同条件 MHA”的理论缓存量,不是这些真实模型之间的显存或速度对比。各代模型的层数、隐藏维度和参数量并不完全相同。
还可以看到,Qwen3-8B 的共享比例比 Qwen2-7B 小。这说明演进并不是一味减少 KV 头,而是在质量、规模和效率之间重新选择配置。配置里的 model_type: qwen2 也不能单独证明使用 GQA,必须检查 Q 头和 KV 头的实际数量。
三、算一笔账:GQA 到底省在哪里?
对采用全注意力、各层配置相同的模型,未量化 KV cache 的主要存储量近似为:
KV cache 字节数 ≈ 2 × 批大小 × 层数 × 序列长度 × KV头数 × 每头维度 × 每元素字节数开头的 2 表示 K 和 V 两份。这个公式不包括模型权重、临时张量、缓存管理开销,也不适用于直接估算混合注意力的所有状态。
假设批大小为 1,模型有 32 层、32 个 Q 头,每头维度 128,上下文为 8192 个 token,K/V 使用 FP16 或 BF16(每元素 2 字节):
同样的空间,现在可以容纳更长的上下文,或者服务更多请求。缓存更小,也让每一步生成少读取一些数据。但如果任务瓶颈主要在其他部分,实际提速就不会与缓存缩减成正比。
四、更进一步:让部分层不再保存完整历史
GQA 仍属于全注意力:只是每个历史 token 保存的 K/V 少了,上下文越长,缓存仍越大。
Qwen3-Next 走了另一条结构上的优化路线。其 80B-A3B 官方模型卡给出了混合结构:48 层中,重复 12 次“3 层 Gated DeltaNet + 1 层 Gated Attention”,每层再接 MoE。
Gated DeltaNet:把历史维护成递推状态
可以把全注意力想成保存一份可以逐条查阅的历史档案,而 Gated DeltaNet 更像持续更新的一份工作记录:新信息进入时,用门控和更新规则调整状态,后续 token 从状态中提取信息。
这个类比的关键是:在逐 token 解码时,线性/递推层的历史状态大小由结构决定,不会像完整 KV cache 那样随 token 数一直增长。因此,长上下文下这些层能减少历史存储和访问开销。
代价是它改变了表示和读取历史的方式,并不等价于对所有旧 token 做完整的 softmax 注意力。保留间隔出现的全注意力层,就是一种能力与效率的折中。
整个模型也没有变成“恒定显存”:12 个全注意力层仍需维护随上下文增长的 KV cache,输入处理和其他运行内存也仍然存在。
Gated Attention:门控不等于 GQA
在这些全注意力层中,Gated Attention 为注意力输出加入门控,用来调节通过的信息。GQA 解决的是 K/V 如何共享;门控解决的是输出如何调节,两者可以同时使用。
Qwen3-Next-80B-A3B 的全注意力层有 16 个 Q 头、2 个 KV 头,因此它本身也使用 GQA。不能因为名称里出现“Gated”,就认为它不再扫描历史,或把门控本身当作主要的缓存压缩手段。
后续 Qwen3.5-397B-A17B也采用这一类混合思路:60 层中有 45 个线性注意力层和 15 个全注意力层。这说明“让部分层递推、保留部分全注意力”成为了千问部分后续模型的重要方向,而不是所有型号都只在 GQA 上继续减少头数。
五、另外两项优化:少激活计算,少走串行步骤
MoE:每个 token 只调用部分专家
注意力之外,Transformer 的前馈网络也很消耗计算。**MoE(混合专家)**准备多个专家网络,再由路由器为当前 token 选择部分专家参与计算。
例如 Qwen3-Next-80B-A3B 总参数约 80B,每个 token 激活约 3B。它的 MoE 包含 512 个路由专家,每个 token 选中 10 个,并有 1 个共享专家。这让模型保留较大的总容量,同时控制每一步的活跃计算量。
但“激活 3B”不意味着只需存放 3B 权重:不同 token 会选择不同专家,部署仍要安排全部权重的存储与访问。路由、专家负载不均和跨设备通信,也会影响实际吞吐。MoE 优化的是前馈计算,不能直接替代 KV cache 优化。
MTP:为一次推进多个 token 提供支持
普通自回归生成需要一步接一步地运行模型。**MTP(Multi-Token Prediction,多 token 预测)**通过训练模型预测未来多个位置,为多 token 草拟和推测解码提供支持。
推测解码可以先草拟多个候选 token,再由目标模型验证,接受符合规则的部分,继续生成。它不是无条件一次输出多个独立答案;能省多少串行步骤,取决于草稿接受率和推理实现。
Qwen3-Next 和上述 Qwen3.5 的官方模型卡都介绍了 MTP。要让它在部署时真正加速,还需要后端支持相应的推理路径;普通加载模型不一定自动启用这项能力。
六、别把所有“更快”都归因于结构变化
实际使用千问时,还会看到 FlashAttention、PagedAttention、量化等名词。它们也很重要,但优化的位置不同:
| 方法 | 主要改变什么 | 与本文主线的关系 |
|---|---|---|
| GQA | K/V 的头共享方式 | 减少缓存和 K/V 数据访问 |
| 混合注意力 | 部分层处理历史的机制 | 用递推状态替代部分完整历史缓存 |
| MoE | 前馈网络的专家激活方式 | 减少每 token 的活跃计算 |
| MTP + 推测解码 | 多 token 草拟与验证流程 | 有机会减少串行生成开销 |
| FlashAttention | 注意力算子的计算与访存实现 | 不等于改变 MHA/GQA;初代 Qwen 已使用 |
| PagedAttention | 服务端 KV cache 的分页管理 | 改善缓存利用和请求调度 |
| 量化 | 权重或缓存的数据精度 | 减少字节数,需要区分量化对象 |
因此,千问从 MHA 出发后的结构优化,可以记成三个问题:历史要保存几份?是否每层都要保存完整历史?生成一个 token,需要激活多少计算、走多少串行步骤? GQA、混合注意力、MoE 与 MTP 分别给出了不同层面的回答。