1. 从一个编码点到一个条件分布
普通 AE 把输入编码成一个确定的潜表示;VAE 的编码器为每个输入预测潜变量分布的参数,再从中采样潜变量进行解码。 两者都有编码器和解码器,但 VAE 同时建立了概率生成模型,并用变分推断训练它。
最容易混淆的是“输出的是哪个分布”。对于输入图像 ,VAE 编码器输出的不是“这张图像本身服从什么分布”,而是:已知图像 后,哪些潜变量 能解释它,以及这些 的相对可能性。 这用近似后验 表示。
VAE 的基本过程是:
VAE 沿用自编码的结构,让编码器根据输入 预测潜变量 的近似后验分布,通常用均值和方差描述。训练时从该分布采样 ,让解码器能够解释、重构 ;同时让近似后验受到一个易于采样的先验约束。训练完成后,可以不输入原图,直接从先验采样 ,用解码器生成具有训练数据统计特征的新样本。
“生成新样本”是合理的直觉,但不能保证生成图像一定没在训练集中出现,更不能保证生成训练分布以外的新知识。模型可能复现训练内容,也可能生成低质量样本;是否记忆、是否多样,需要另做评估。
Kingma 与 Welling 的 《Auto-Encoding Variational Bayes》 于 2013 年首次提交,是 ICLR 2014 的工作。论文提出 SGVB 估计器和 AEVB 学习算法,VAE 是采用神经网络编码器、解码器的一种具体实例。以下图号及实验设置对应 arXiv v11。
2. 普通 AE 到底在学什么
2.1 编码、解码与重构
自编码器(Autoencoder,AE)使用输入本身作为重构目标,通常归入无监督学习,也可以从自监督的角度理解。它的基本形式是:
其中, 表示编码器参数, 表示解码器参数。训练优化的是网络参数,而 是网络处理某个样本后得到的表示。
编码器提取信息,解码器用这些信息重构输入。MLP、CNN,以及适合序列的循环网络都可以承担这些角色。最简单的像素重构损失为:
也可以根据数据与输出定义使用二元交叉熵。压缩瓶颈、噪声或其他正则约束很重要:只要求输入等于输出,容量足够的网络可能只学会复制。
潜表示 可以是向量,也可以是带空间结构的特征图。编码时逐层降维、解码时逐层升维是一种常见设计,并非必要条件;过完备自编码器的潜维度甚至可能大于输入维度。
2.2 U-Net 与 AE 的关系
U-Net 是带跳跃连接的编码器—解码器架构,其原始论文做的是生物医学图像分割。具有编码器和解码器,不等于就是自编码器;是否在重构输入、如何设置目标,才决定它在做什么。
可以用类似 U-Net 的组件搭建重构网络,但它不是解释原始 AE 或原始 VAE 时的默认架构。原始 VAE 的实验采用的是全连接 MLP,没有 U-Net 的多尺度跳跃连接。
2.3 为什么 AE 不方便直接随机生成
普通 AE 只保证训练样本的编码经解码后尽量回到原样,通常没有指定一个简单的潜空间采样分布,也没有约束随意抽到的潜点都能解码成合理样本。
例如,训练样本的编码可能落在潜空间若干分散区域。随手采一个高斯向量,可能落进解码器没学好的区域。问题不在于“确定性网络绝对无法生成”——确定性解码器也可以把随机输入变成随机输出——而在于普通 AE 的训练目标没有把采样机制一起学好。
| 对比项 | 普通 AE | 经典高斯 VAE |
|---|---|---|
| 编码结果 | 一个确定表示 | 分布参数 |
| 潜变量来源 | 直接使用编码值 | 重构时从 采样 |
| 解码器含义 | 把表示映射回重构值 | 给出条件分布 的参数 |
| 核心目标 | 重构及可选正则 | 最大化 ELBO,等价于最小化重构负对数似然加 KL |
| 无条件生成 | 需要额外确定如何采样潜变量 | 从先验 采样再解码 |
3. 原始论文做了什么任务,用了什么数据
3.1 方法解决的问题与实际实验要分开
原论文研究的是:面对连续潜变量、难以计算的真实后验和大规模数据,怎样高效地同时学习生成模型与近似推断模型。
论文讨论了生成、表示、去噪和补全等潜在用途,主要实验是图像的无监督概率建模、生成和低维流形可视化,不涉及监督数字分类。
| 数据集 | 数据内容 | 原论文中的任务 | 解码器观测分布 |
|---|---|---|---|
| MNIST | 手写数字灰度图像 | 学习图像生成模型;比较 ELBO、估计边际似然;展示潜空间和随机生成样本 | 用于二值观测建模的 Bernoulli 输出 |
| Frey Face | 人脸灰度图像,包含表情与姿态变化 | 学习连续图像的生成模型;比较 ELBO;展示二维潜流形 | 对角高斯输出,均值通过 sigmoid 限制在 |
Bernoulli 是观测模型的选择;论文实验说明未明确给出每轮动态二值化的处理规则。
3.2 实验架构与比较对象
根据论文第 5 节及附录 C:
- 在主要的 ELBO 对比中,MNIST 的编码器、解码器各有一个 500 单元的隐藏层;Frey Face 各使用 200 单元,以适应更小的数据集、减轻过拟合。
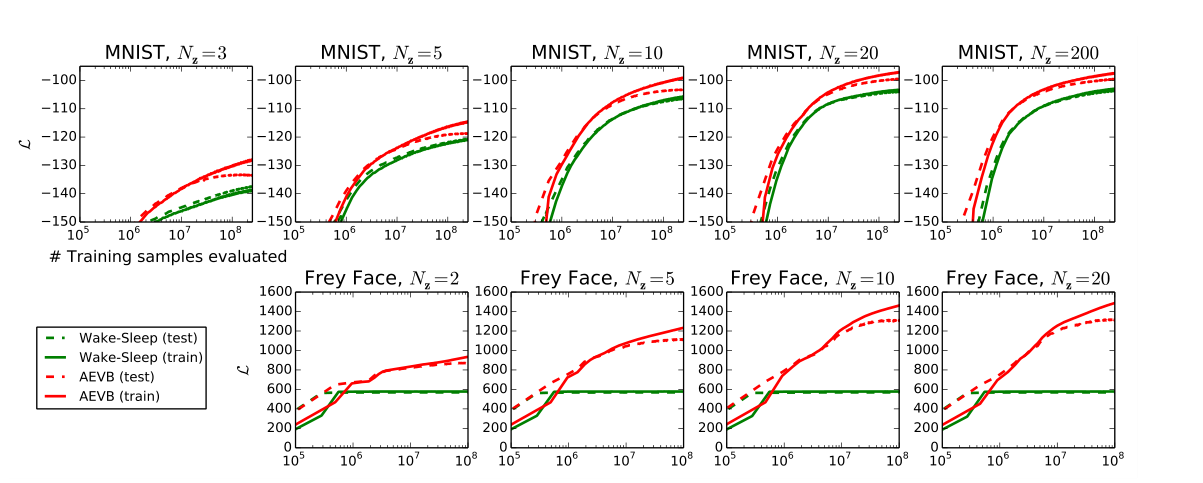
- 图 2 的 MNIST 潜维度包括 3、5、10、20、200;Frey Face 包括 2、5、10、20。隐藏层单元数和潜变量维度是两件不同的事。
- 在单独的边际似然比较中,采用 100 隐藏单元、3 个潜变量的网络;MNIST 的训练子集规模为 1000 和 50000。这一设置仅用于该组比较实验。
- 主要与 Wake-Sleep 比较;边际似然实验还比较了使用 HMC 的 Monte Carlo EM。后者的采样属于比较方法或评估过程,不是 VAE 每个训练样本都要执行的步骤。
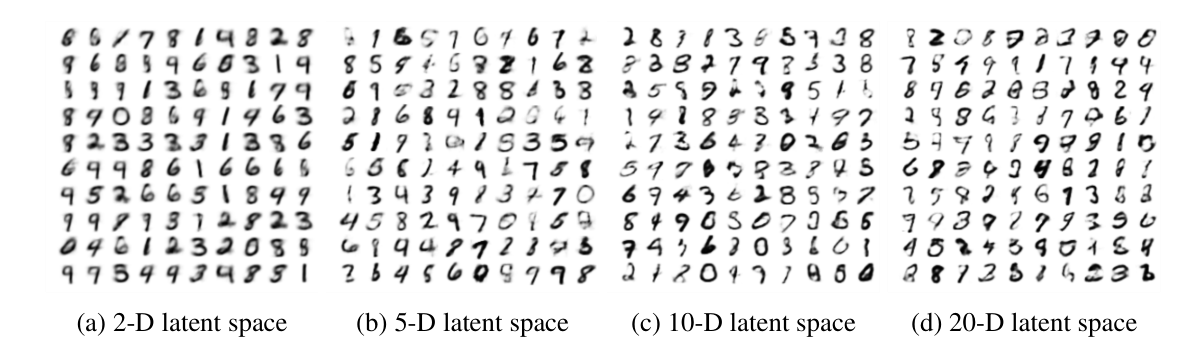
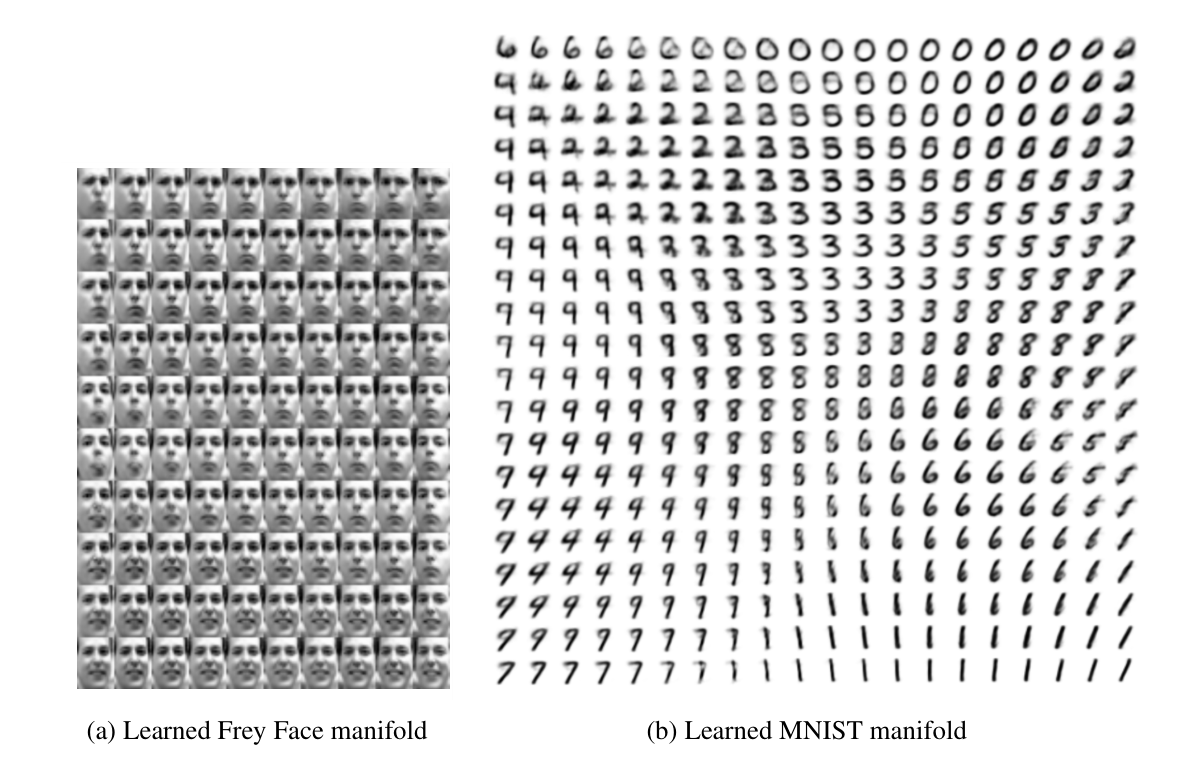
- 图 4 展示二维潜流形;图 5 展示 2、5、10、20 维潜空间模型的 MNIST 随机样本。
4. 论文架构:生成方向与推断方向
4.1 官方原图怎么读
原论文图 1 用有向概率图表示生成模型与近似推断模型的关系:
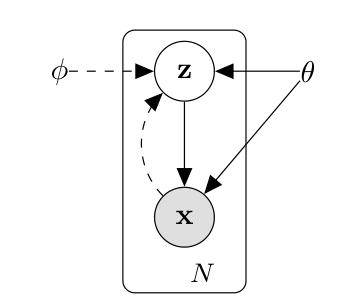
生成方向是 ,推断方向是 。 编码器是为了高效推断而加入的;生成新图时只需要先验和解码器。
4.2 编码器:预测潜变量的均值与对数方差
经典设置固定先验为:
编码器先通过一个隐藏层提取表示,再由两个输出头预测 维向量:
由它们构造:
这里 不是唯一的“真实编码”, 也不是训练过程中所有图像共用的常数;每个输入都会产生自己的条件分布参数。输出对数方差便于让网络输出任意实数,再通过指数得到正方差。这种参数化在原论文附录 C 中已出现。
4.3 解码器:输出给定潜变量时的观测分布
采到 后,解码器通过另一个单隐藏层 MLP,给出 的参数。
- Bernoulli 解码器:,。 是第 个二值像素为 1 的概率;展示 时看到的是均值图,若逐像素抽样则得到一次随机观测。
- 高斯解码器:输出像素均值与对数方差。对 Frey Face,原论文额外用 sigmoid 将均值约束到 。此处的高斯输出方差与编码器的潜变量方差不是同一个量。
以 MNIST 主实验为例,可以把实际尺寸写成:
这就是一个展平图像上的 MLP VAE。卷积 VAE 可以把上述隐藏表示换成特征图,但概率关系与训练目标仍然适用。
5. “变分”究竟指什么
5.1 想求的是后验,困难来自归一化积分
先建立生成模型,再问一个反向问题:已知观察到的 ,什么样的潜变量 能解释它?贝叶斯公式给出:
解码器是非线性神经网络时,积分通常无法高效精确计算,真实后验也就难以直接计算。
“变分”的直觉来自在一族函数或分布中寻找最优对象:与只寻找一个数使 最小不同,变分推断选择一个可计算的分布族,让其中的 逼近真实后验。分布本身是一个函数,这也是“变分”这个名字背后的联系。
实际 VAE 不会遍历所有可能分布,而是预先选定分布族,例如对角高斯,再用有限维神经网络参数 优化。 均值和方差是该分布族的参数化方式;“变分”指近似推断这件事,不能简单解释为“加了随机噪声”或“方差发生变化”。
5.2 为什么不直接最小化与真实后验的 KL
理论上,对于固定生成模型,希望:
但真实后验含有难算的 。因此采用等价关系:
因为 KL 非负,ELBO 不大于对数边际似然。固定 时,最大化 ELBO 等价于减小后验近似的 KL;联合训练时,还同时学习 ,让模型更好地解释数据。 有限的近似分布族不保证能完全表示真实后验。
6. 训练损失:重构负对数似然加 KL
6.1 ELBO 与用于最小化的损失
将 ELBO 展开:
原论文最大化这个目标;在常用最小化损失的写法中,取其负值:
这是由概率模型推导出的“重构负对数似然 + KL”,并非随意将 MSE 和一个正则项拼在一起。 KL 的系数在标准 ELBO 中是 1;如果另加 ,就改变了优化目标,不能当成原始公式。
这里涉及两个不同的 KL:上节恒等式衡量近似后验与真实后验的差距;可计算损失中的 KL 则约束近似后验与先验的距离。 是观察到输入后的后验, 是观察输入前的先验。
6.2 重构项什么时候是 BCE,什么时候像 MSE
若选择独立 Bernoulli 观测模型,解码器给出概率 ,其负对数似然为:
这就是逐像素二元交叉熵(BCE),对应原论文 Bernoulli 解码器的公式。它不是数字类别标签的十分类交叉熵。
若观测模型为固定方差 的高斯:
则负对数似然等于 加常数,因此与平方误差成比例。如果解码器还预测方差,完整高斯负对数似然包含对数方差项,不能直接用裸 MSE 代替:
6.3 高斯 KL 可以直接算,不需要再抽样估计
当 、 时:
若网络输出 ,则写成:
均值全为 0、方差全为 1 时,KL 等于 0;偏离这一先验会增加代价。这有利于让潜空间可采样,但KL 本身不保证每个点都生成高质量图像,也不保证潜维度自动对应可解释语义。
重构项鼓励保留样本细节,KL 则限制每个样本的编码分布偏离先验太远,两者形成平衡。如果所有输入都得到完全相同的先验、解码器又忽略 ,便无法靠潜变量区分样本;“KL 越小越好”不是完整的训练目标。
7. 特殊训练策略:重参数化是关键
7.1 把随机性移到与参数无关的噪声上
直接把“从依赖参数的分布中采样”当成普通计算节点,无法直接使用熟悉的路径反向传播。高斯 VAE 将它改写为:
这样得到的 仍服从同一个 ,但随机数来自不依赖参数的 ;固定一次噪声实现后, 对 都是可微的,重构损失就能经解码器、 传回编码器。
重参数化没有取消随机性,也没有把采样改成总取均值,而是改变了采样的计算表达,让梯度更容易、低方差地估计。 其他分布也可能有可用的重参数化,但不能把这个高斯公式原封不动套到所有离散变量上。
7.2 原论文实际使用的训练配置
| 项目 | 论文设置或策略 | 为什么重要 |
|---|---|---|
| 优化对象 | 联合优化编码器 和解码器 | 推断与生成模型一起学习,无需先单独训完 AE |
| 梯度估计 | SGVB 与重参数化 | 通过随机目标做高效梯度优化 |
| KL 项 | 高斯情形使用解析式 | 只需对重构期望采样,降低估计方差 |
| 小批量大小 | 随机批量优化,适应较大数据集 | |
| 每个样本的潜采样数 | 论文在足够大的小批量下使用一次采样估计重构期望 | |
| 优化器 | Adagrad | 按参数累计梯度平方,自适应调整更新步长 |
| 全局步长候选 | 根据最初若干轮训练集表现选择 | |
| 初始化 | 从 随机采样 | 使用零均值的小幅随机初始化 |
| 参数正则 | 对应 的小权重衰减 | 实验采用近似 MAP;这与潜变量的 KL 是不同层面的约束 |
| 非线性 | MLP 隐藏层使用 tanh;Bernoulli 输出使用 sigmoid | 对应附录 C 的实际网络 |
原始方案的要点是重参数化、共享编码网络的摊销推断、解析 KL 与小批量联合训练。所谓摊销推断,是指所有样本共用一个编码器:处理新输入时一次前向计算就得到分布参数,无需为每个样本重新迭代拟合一套变分参数。
论文没有将 KL warm-up、循环退火、free bits、-VAE、感知损失或对抗训练作为这里的标准训练配方。后续工作可能采用这些改动;本节只记录原论文使用的策略。附录 E 另提到比较算法采用 Adagrad 及配套步长退火,但这不等于对 KL 权重做退火。
7.3 一轮训练可以怎样对应到代码
Bernoulli 观测模型的一轮训练可表示为:
mu, logvar = encoder(x)
epsilon = standard_normal(shape=mu.shape)
z = mu + exp(0.5 * logvar) * epsilon
logits = decoder(z)

# 每个样本内部求和,再在 batch 上平均
reconstruction = sum_over_pixels(binary_cross_entropy_with_logits(logits, x))
kl = -0.5 * sum_over_latents(1 + logvar - mu**2 - exp(logvar))
loss = mean_over_batch(reconstruction + kl)

jointly_update(encoder_parameters, decoder_parameters, loss)
使用 logits 版本的 BCE 时,不要再手动先做一次 sigmoid。若将像素重构项改成“每像素平均”而 KL 仍对潜维度求和,两项比例就变了;比较实现时要同时检查 reduction、观测方差和 KL 权重。
8. 重构、生成与潜空间可视化有什么不同
8.1 给定一张图,做重构
这里的潜变量来自与该图像相关的近似后验,所以输出应尽量保留原图的信息。为了稳定展示,可以取 并显示解码器均值,但这只是常用展示方式,不等于训练时不需要采样。
8.2 不给原图,生成一个新样本
无条件生成时从先验采样,不是先输入一张不存在的新图来求后验。 展示解码器均值图与继续从观测分布抽样也应区分:二者都常用于观察模型,随机性却不完全相同。
从标准正态直接采样在数学上完全可行;生成质量依赖训练是否学好了先验区域到数据空间的映射。训练使用后验,生成使用先验,KL 正是连接两者的重要部分。
8.3 为什么潜空间能呈现连续变化
训练中同一图像的潜变量会在分布内扰动,解码器需要对这些邻近编码给出合理解释;同时 KL 限制编码分布的形态。这使模型倾向于形成可连续探索的潜空间,但不意味着空间中没有“空洞”,也不保证线性插值始终经过高概率区域。
9. 常见概念辨析
| 常见说法 | 更准确的理解 |
|---|---|
| “VAE 本质就是 AE 加噪声” | 结构类似自编码器,但引入潜变量生成模型、变分近似与 ELBO;噪声只是实现采样的一部分 |
| “编码器输出图像服从的分布” | 输出给定图像后的潜变量分布 的参数 |
| “VAE 不再有特征 ” | 仍有潜表示 ,只是其来源变为分布采样 |
| “变分就是输出均值和方差” | 均值与方差参数化近似分布;变分推断是用可优化分布族逼近难算的后验 |
| “KL 是让 接近真实后验” | 在 ELBO 差距恒等式中确实有这个 KL;实际可计算损失中的 KL 比较的是近似后验与先验 |
| “训练后整个数据集就是一个高斯” | 先验选为高斯,各输入后验也可选高斯;数据空间的 经非线性解码和积分后通常远非单一高斯 |
| “所有输入的后验都要完全等于标准正态” | KL 是软约束,要与重构项平衡;强行完全相同可能丢失样本信息 |
| “普通 AE 不能输出新图” | 能对新潜点解码,但通常缺少被训练目标约束好的采样分布 |
| “VAE 一定采到训练集没有的图” | 可以生成未逐一存储的组合与外观,但是否新颖、是否记忆训练样本需要验证 |
10. 用四个问题复述这篇论文
- 任务与数据集是什么? 无监督潜变量图像建模,使用 MNIST 和 Frey Face,比较 ELBO、估计边际似然,并展示潜流形与生成样本。
- 架构是什么? 标准正态先验、单隐藏层 MLP 高斯编码器、重参数化采样,以及 Bernoulli 或高斯 MLP 解码器;官方架构图是有向概率图。
- 损失是什么? 最大化 ELBO;最小化写法为重构负对数似然加解析高斯 KL。实验还包含参数权重衰减,对应近似 MAP。
- 特殊训练策略是什么? SGVB 重参数化梯度、摊销推断、解析 KL、小批量联合训练;原实验采用 Adagrad、批大小 100、每个样本一次潜采样。
AE 为每个输入学习一个编码点;VAE 为每个输入学习一个可采样的近似后验,并把它与一个可生成的概率模型一起训练。